Como Adicionar Dados Estruturados no Nuxt.JS

Aqui você vê o que são Dados Estruturados, quando usar, quando não usar e como marcar os artigos do seu blog no Nuxt.JS com o nuxt-schema-org. Depois vem a validação da marcação e o que fazer para o Google descobrir e indexar o conteúdo e, quando possível, recomendá-lo no Discover.
O que são Dados Estruturados?
Dados estruturados são informações de um site que estão organizadas de forma padronizada em formatos como JSON-LD, Microdata ou RDFa. O Google recomenda o JSON-LD, que fica separado do HTML visível e é o mais simples de manter, e é o formato que vamos usar aqui.
Através dos dados estruturados os mecanismos de busca como o Google recebem mais informações sobre o que se trata a sua página e, com base nessas informações, juntamente com outros fatores, os mecanismos de busca podem fazer a exibição de Resultados Ricos de páginas do seu site nos resultados de busca.
O que são Rich Snippets ?
Os Rich Snippets ou Resultados Ricos são melhorias visuais nos resultados de busca como imagens, preços, breadcrumbs, estrelas de avaliação, etc.
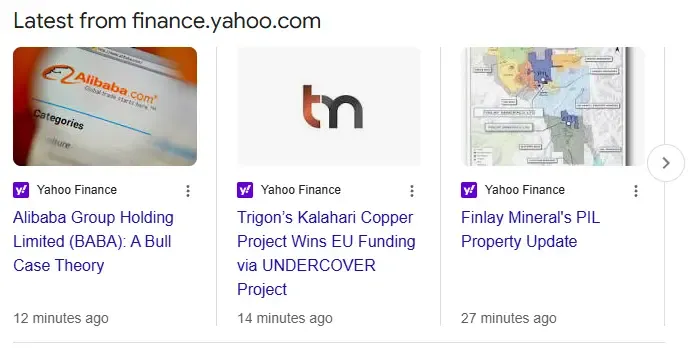
Abaixo você pode conferir um exemplo de Resultado Rico no Google do site Yahoo Finances, onde uma imagem é exibida, título e data de publicação. Essas informações e recursos visuais aumentam a chance de chamar a atenção do usuário e fazer ele acessar o seu site.
Exemplo do Código de Dado Estruturado
Abaixo você pode ver um exemplo de dados estruturados em JSON-LD. Não se preocupe, você não vai precisar escrever isso manualmente, vamos usar uma ferramenta do Nuxt para gerar o código.
Este exemplo usa
FAQPage, que foi o tipo mais comum de resultado rico durante anos. O Google parou de exibir o resultado rico de FAQ em 7 de maio de 2026, para qualquer tipo de site, e removeu a documentação do recurso em junho. A marcação continua válida no schema.org, mas hoje ela só descreve o conteúdo e não muda a aparência do seu resultado na busca.
<script type="application/ld+json">
  {
    "@type": "FAQPage",
    "@context": "https://schema.org",
    "@graph": [
      {
        "@id": "https://codigoaoponto.com/tools/cpf-generator/#/schema/question/c6e1aab",
        "@type": "Question",
        "inLanguage": "pt-BR",
        "name": "O que é um Gerador de CPF?",
        "acceptedAnswer": {
          "@type": "Answer",
          "text": "Um Gerador de CPF é uma ferramenta que gera números de CPF válidos, sendo útil para testes e desenvolvimento de sistemas. Ele aplica o algoritmo oficial de validação do CPF para assegurar que os números criados estejam formatados corretamente."
        }
      }
    ]
  }
</script>
Quando usar dados estruturados?
Use Dados Estruturados quando:
- O conteúdo da página for de alguma das categorias suportadas, como exemplo: artigos, produtos, receitas, eventos, vagas de emprego, etc.
- Desejar aumentar a visibilidade das suas páginas e a taxa de cliques (CTR).
- Querer ajudar mecanismos de busca a entender melhor o conteúdo do seu site.
Em qualquer caso, o que você marca precisa estar visível para o usuário na página, e as propriedades precisam ser mantidas atualizadas.
Quando não usar dados estruturados ?
Evite usar Dados Estruturados quando:
- Conteúdo da página não se encaixa nas categorias suportadas.
- Conteúdo de baixa qualidade, os dados estruturados não auxiliam na melhoria do conteúdo.
- Conteúdo mudar com frequência, pois se tornará custoso realizar atualizações tão frequentes dessas informações.
- O conteúdo marcado não aparece na página. O Google trata isso como uso indevido de dados estruturados e pode aplicar uma ação manual no seu site.
Instalação do pacote Schema.org no Nuxt
O Nuxt SEO é uma coleção de módulos de SEO que facilitam o desenvolvimento de SEO técnico para o seu site. Para este tutorial nós vamos utilizar o módulo que facilitará a implementação dos estruturados.
Você pode realizar a instalação desse módulo de várias formas, aqui vou exemplificar as duas principais:
- nuxi (Interface de linha de comando oficial do Nuxt)
- npm (Gerenciador de pacotes)
Se você for utilizar o nuxi, basta executar o seguinte comando:
npx nuxi module add schema-org
Se você for utilizar o npm, terá que fazer uma etapa extra, comece instalando o pacote:
npm i nuxt-schema-org
E depois adicione o pacote instalado na opção de modules dentro do arquivo nuxt.config.ts:
export default defineNuxtConfig({
  // outras configurações....
  modules: [
    // outros módulos
    "nuxt-schema-org"
  ]
  // outras configurações...s
});
Feito isso, já podemos começar a utilizar a ferramenta.
Dados Estruturados para Artigos no Nuxt.JS
Para um blog, o tipo mais útil é o Article. Ele diz ao Google que a página é um artigo, quem escreveu, quando foi publicado e atualizado e qual imagem o representa. O Google não exige nenhuma propriedade para Article, mas recomenda estas:
headline: o título do artigo.image: uma imagem representativa. O Google recomenda várias imagens em alta resolução, nas proporções 16x9, 4x3 e 1x1.datePublishededateModified: data da primeira publicação e da última modificação, em formato ISO 8601.author: de preferência umPersoncomnameeurl, apontando para uma página que identifique o autor.publisher: a organização por trás do site, com nome e logo.
No Nuxt estará disponível de forma global o composable chamado useSchemaOrg, que você pode usar dentro da tag script da página. Em uma página de blog que carrega o post com o Nuxt Content, ele fica assim:
<script setup lang="ts">
const route = useRoute();

const { data: post } = await useAsyncData(`post-${route.path}`, () =>
  queryCollection("blog").path(route.path).first()
);

useSchemaOrg([
  defineArticle({
    headline: post.value?.title,
    description: post.value?.description,
    image: post.value?.articleCover,
    datePublished: post.value?.publishedAt,
    dateModified: post.value?.updatedAt ?? post.value?.publishedAt
  }),
  defineBreadcrumb({
    itemListElement: [
      { name: "Home", item: "/" },
      { name: "Blog", item: "/blog" },
      { name: post.value?.title }
    ]
  })
]);
</script>
Os campos vêm do front matter do artigo, então o dateModified só reflete a realidade se você atualizar o updatedAt quando mudar o conteúdo de verdade. O módulo converte as datas para ISO 8601 e transforma o caminho da imagem em URL absoluta a partir da url do site.
Configuração global do site
Autor e editora não precisam ser repetidos em cada página. O nuxt-schema-org usa a configuração do site e a identidade da organização, que você define uma vez no nuxt.config.ts:
export default defineNuxtConfig({
  site: {
    url: "https://seusite.com",
    name: "Nome do Site"
  },
  schemaOrg: {
    identity: defineOrganization({
      name: "Nome do Site",
      logo: "https://seusite.com/logo-512.png"
    })
  }
});
Se o Article não tiver publisher, o módulo usa essa identidade. Para o autor, passe um Person com name e url no defineArticle.
Como as entidades se ligam
O módulo monta um único @graph em que WebSite, WebPage, Article, Person e Organization se referenciam por @id. O Article aponta para a WebPage atual, e o author e o publisher apontam para os nós de Person e Organization. Essa ligação diz ao Google que o artigo pertence àquele autor e àquela marca.
E o FAQPage?
Se a página tem uma seção de perguntas e respostas visível, ainda vale marcar com FAQPage. Só não espere o dropdown na busca. O exemplo abaixo gera o mesmo JSON-LD que vimos antes:
<script setup>
useSchemaOrg([
  defineWebPage({
    "@type": "FAQPage"
  }),
  defineQuestion({
    name: "O que é um Gerador de CPF?",
    acceptedAnswer:
      "Um Gerador de CPF é uma ferramenta que gera números de CPF válidos, sendo útil para testes e desenvolvimento de sistemas. Ele aplica o algoritmo oficial de validação do CPF para assegurar que os números criados estejam formatados corretamente."
  }),
  defineQuestion({
    name: "Como funciona o Gerador de CPF?",
    acceptedAnswer:
      "O Gerador de CPF cria aleatoriamente os nove primeiros dígitos do CPF e, em seguida, calcula os dois dígitos verificadores usando o algoritmo de validação oficial, assegurando que o número gerado seja válido."
  })
]);
</script>
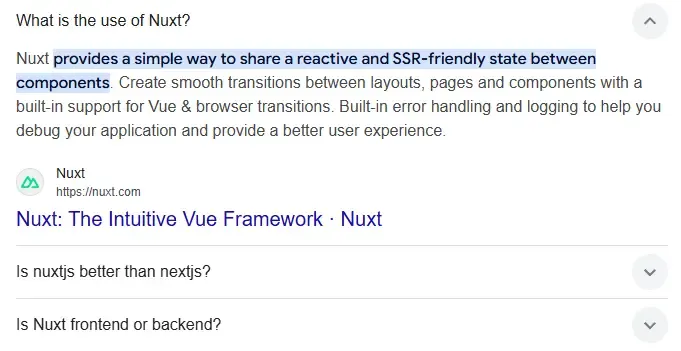
Até maio de 2026, essa marcação podia render um resultado rico como o da imagem abaixo:
Como conferir se o JSON-LD está no HTML
Abra a página no navegador e use "Ver código-fonte da página", não "Inspecionar elemento". Procure por um bloco <script type="application/ld+json">. O nuxt-schema-org injeta o JSON-LD durante a renderização no servidor, então ele precisa estar no HTML bruto. Se ele só aparecer depois da hidratação, revise a configuração de renderização da página.
Como validar os dados estruturados
Depois de publicar, valide a página com estas ferramentas:
- Teste de Resultados Ricos do Google: mostra os itens detectados na URL e lista erros e avisos.
- Validador do Schema Markup: confere a sintaxe do JSON-LD segundo o schema.org, independente de o Google exibir um resultado rico.
- Relatório de dados estruturados no Search Console: agrupa os erros e avisos do site inteiro.
Os problemas mais comuns em blogs são estes:
- Propriedade recomendada ausente, como
imageouauthor. Não é erro crítico emArticle, mas limita o que o Google pode usar. - Imagem pequena ou inacessível. Para o Discover, a imagem precisa ter pelo menos 1200 px de largura e a URL não pode estar bloqueada para o rastreador.
- Data em formato inválido. Use ISO 8601, como
2026-10-03ou2026-10-03T14:30:00-03:00. - Marcação diferente do conteúdo visível. Título, autor, data e imagem do schema devem ser os mesmos que o usuário vê na página.
Como fazer o Google indexar o seu artigo
Dados estruturados corretos não adiantam se o Google não indexar a página. O fluxo para um artigo novo é este:
- Confirme que a URL está no
sitemap.xmle que o sitemap está enviado no Search Console. No Nuxt, o módulo@nuxtjs/sitemapgera esse arquivo. - Cole a URL no campo "Inspecionar qualquer URL" do Search Console.
- Clique em "Solicitar indexação".
O pedido de indexação coloca a URL numa fila de rastreamento, mas não garante a indexação, e o Google não informa o prazo. O Google também não publica o limite diário de pedidos. Quando você o atinge, o botão fica indisponível até o dia seguinte, então use só para URLs importantes e não reenvie a mesma página várias vezes.
Para as demais páginas, o que ajuda o Google a descobri-las são o sitemap e os links internos. Uma página sem nenhum link vindo de outras páginas do site tende a ser descoberta mais devagar. Crie links para os artigos novos a partir da listagem do blog e de posts relacionados.
Descoberta, mas não indexada
No relatório de indexação de páginas, dois status confundem muita gente:
- Descoberta, mas não indexada no momento: o Google conhece a URL, mas ainda não a rastreou. Reforce os links internos, confira se a URL está no sitemap e verifique se o servidor não está devolvendo erros 5xx ou respondendo devagar.
- Rastreada, mas não indexada no momento: o Google já leu a página e decidiu não indexá-la por enquanto. Costuma ser uma questão de qualidade: conteúdo muito parecido com outro já indexado, pouco aprofundado ou fora da intenção de busca. Melhore o conteúdo e só depois peça a indexação de novo.
Como aparecer no Google Discover
O Discover é o feed de conteúdo do app do Google e de navegadores móveis. Ele mostra conteúdo conforme os interesses de cada usuário, sem depender de uma pesquisa. Segundo a documentação do Google, para ser elegível o conteúdo precisa:
- Estar indexado e seguir as políticas de conteúdo do Discover, sem clickbait nem sensacionalismo.
- Ter uma imagem com pelo menos 1200 px de largura e mais de 300.000 pixels no total, na proporção 16x9, e a meta robots
max-image-preview:largehabilitada. - Ser um conteúdo original, útil e feito para pessoas.
Nenhum dado estruturado é obrigatório para o Discover. Mas o Google usa o image do schema.org e a meta tag og:image para escolher a imagem do card, então vale manter as duas apontando para uma imagem boa e não usar o logo do site no lugar.
No Nuxt, a meta robots pode ser definida na própria página:
<script setup>
useSeoMeta({
  robots: "index, follow, max-image-preview:large"
});
</script>
O desempenho no Discover aparece no relatório próprio do Search Console. Se o seu site não tiver dados lá, o conteúdo ainda não está sendo exibido no feed.
Avisando o Bing com IndexNow
O IndexNow é um protocolo adotado pelo Bing e por outros buscadores para avisar quando uma URL é criada, atualizada ou removida. Você gera uma chave, publica um arquivo .txt com ela na raiz do domínio e faz uma requisição ao endpoint do IndexNow sempre que publicar ou atualizar um artigo. Isso avisa o buscador de que existe algo novo, mas não garante indexação imediata. O guia oficial está em bing.com/indexnow/getstarted.
Perguntas frequentes
Preciso de dados estruturados para o meu blog rankear?
Não. Eles não são obrigatórios para rankear, mas ajudam o Google a entender melhor os seus artigos. Para um blog, o ponto de partida é Article com autor e imagem, mais o breadcrumb.
Vale a pena manter FAQPage se ele não gera mais resultado rico?
Vale se a página tem uma seção de perguntas e respostas visível para o usuário. Nesse caso a marcação serve para descrever o conteúdo.
Dados estruturados garantem que meu post apareça no Discover?
Não. O Discover não exige dados estruturados. O que pesa é o conteúdo estar indexado, ter uma imagem grande e seguir as políticas de conteúdo.
Meu artigo aparece como "Rastreada, mas não indexada". O que fazer?
Esse status costuma apontar para a qualidade ou a originalidade da página. Melhore o conteúdo, reforce os links internos e peça a indexação de novo depois.
Como sei que o Google está lendo o meu JSON-LD?
Confira o HTML bruto em "Ver código-fonte da página", teste a URL no Teste de Resultados Ricos e acompanhe o relatório de dados estruturados no Search Console.
Conclusão
Em cada artigo novo, marque o Article com autor, imagem e datas, confira o JSON-LD no código-fonte, valide no Teste de Resultados Ricos e acompanhe o relatório de indexação no Search Console. Atualize o updatedAt só quando o conteúdo mudar de verdade e, se o Bing importa para você, configure o IndexNow.
Se você quiser se aprofundar, acesse a documentação completa do módulo, a documentação do Google sobre dados estruturados de Article e a documentação do Google Discover.